

バイトニックソート(Bitonic Sort)の概要
バイトニックソート(Bitonic Sort)は主にGPU等の並列計算器でソートを実装しようとするときに使われるソートである。計算量のオーダーはO(n log^2 n)であり、クイックソートのO(n log n)には負けるものの並列化による高速化が勝るという感じなのでいろんなところに使われている。
対象読者
キーワード「GPU」「バイトニックソート」で検索してこの記事にたどり着いただろう方が対象。この記事では
・バイトニックソートでなぜソートできるか
・どうやったら高速化できるか
という点について重点的に書いている。
高速化については
OpenCLでバイトニックソートを実装している海外サイト
を
これのComputeShader移植+αかつ日本語資料として、一応価値はあるかと思うのでまとめてみた。
時間がない方は完成版コードの
BitonicSort_ComputeShader
をご参照を。
ソートはソートでも、ただ配列をソートしているのではなく、配列のもとのindexを保持したままソートしている実装なので可読性より実用性重視になっている。
アルゴリズム
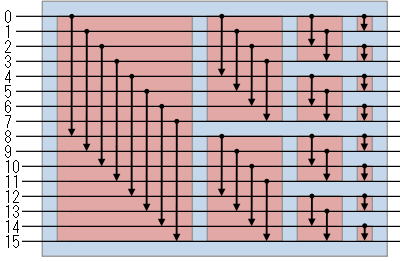
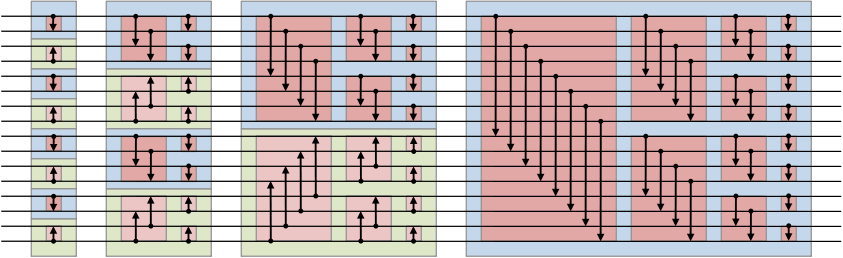 とりあえず英語のwikipediaの画像がわかりやすいので転載してみた。
16要素のソートの場合のアルゴリズムを図示したもののようだ。
左から見ていく。
最初はソートされてない数字が縦に並んでいて、縦の矢印のところで比較、swapが行なわれるという意味らしい。
矢印の方向によって大きい値が矢印の先に移動するといった具合でやると、最終的に一番画面右の時点で上から小さい順に数字が並んでいる状態になる。
なぜソートできるのか
4要素の時
あまり数学的な説明はできないが、自分の思考過程をまとめてみた。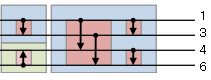
まず4要素のソートで考える。(2だと自明すぎるので)
最終的にこのような形にするためには、という考え方をすると後ろから見ていくとよさそうだ。
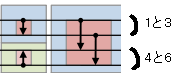
この時点で、上2つは1と3が、下2つは4と6が入ってないと絶対いけない。
つまりこの図の操作(矢印の数でいうと4回)後には、上に小さい方が値2つ、下に大きい方の値2つが振り分けられてないといけないことがわかった。
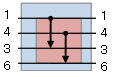
この操作だけでは、1,4,3,6と入力したときに「1,4」「3,6」となり振り分けが不十分だ。
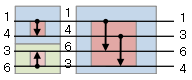
やっぱり最初の操作をしないと「1,3」「4,6」の振り分けがうまくいかないようだ。
要素数がもっと大きいとき
それではもっと要素数が大きくなった場合に、この「振り分け」が常にきちんとできているのか気になる。例えば
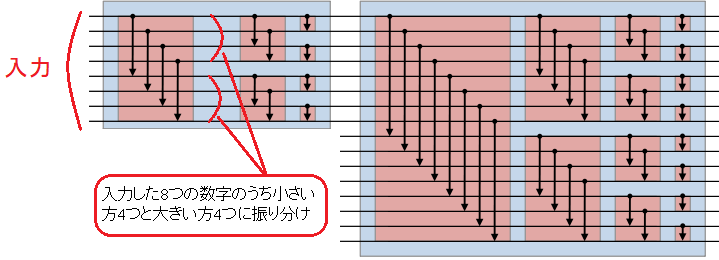
このように2n個の数字を入力すると、大きい方n個、小さい方n個に分けられて出力されないといけない。
と、ここで入力側は真ん中を境に2方向にソートされていたことを思い出す。
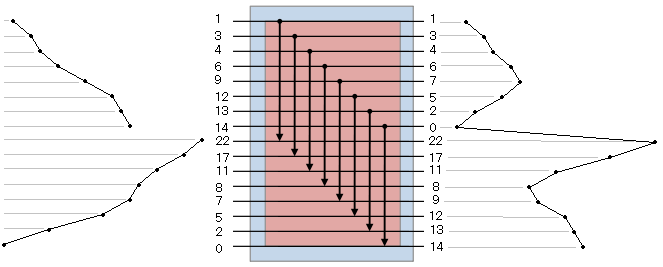
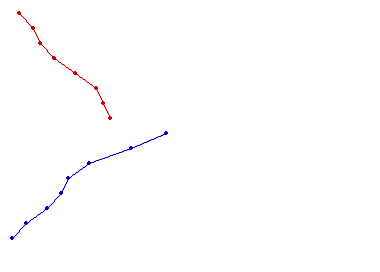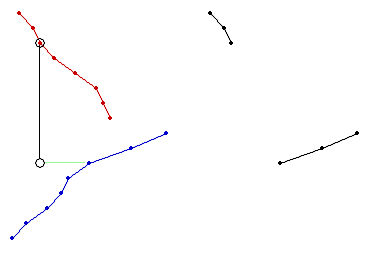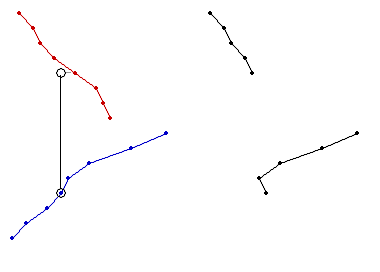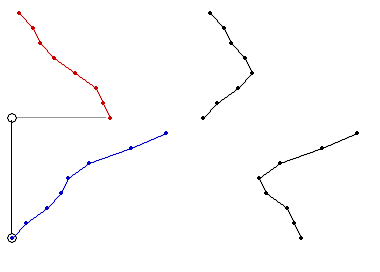
このように入力がソートされていれば、16入力のうち小さいものと大きいものを8個ずつに分けることができる。
例えば小さい方の8個というのは、赤の数値を小さい順にみて集めていき、赤と青のお互いの上下がひっくりかえったところで今度は青の数値を集めていけば、それが必ず小さい8個の集合になる。
256入力になったときの図
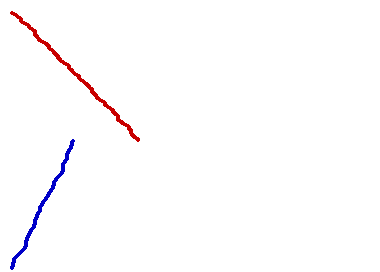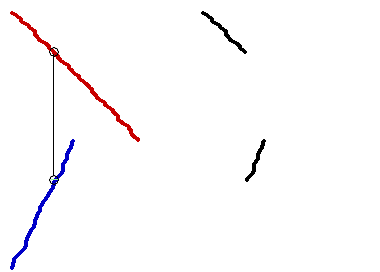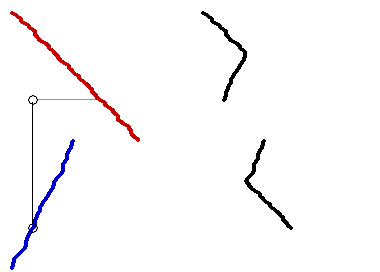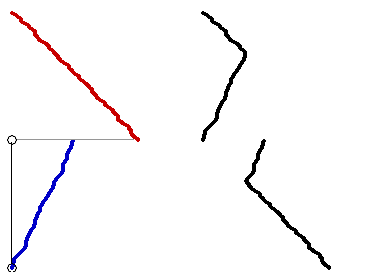
この例を見ても確かにうまくふるい分けられている。
Bitonic sequence
では今の現状を整理する。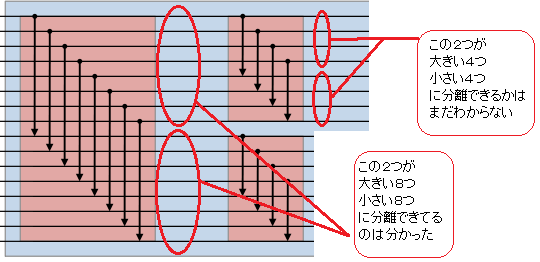
真ん中でソートされているn+nの入力ならば、出力側で上下分離できていることが分かった。
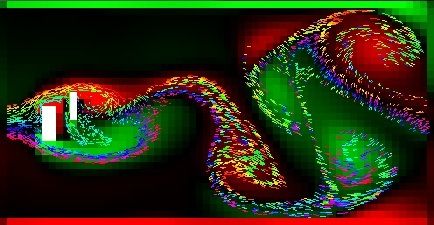
しかし先ほどのgifの出力の「へ」の字みたいなのは必ずしも真ん中でソートされているわけではない。それが次の入力になっているが、はたして大丈夫なのか。
実際にやってみた。
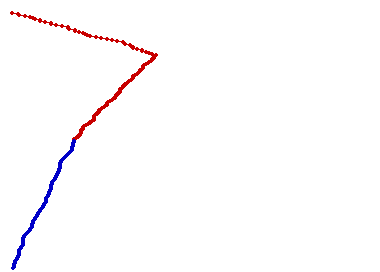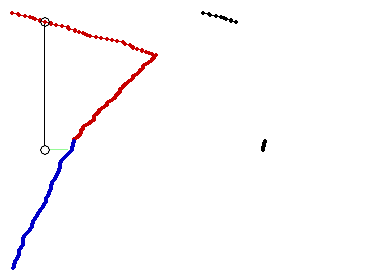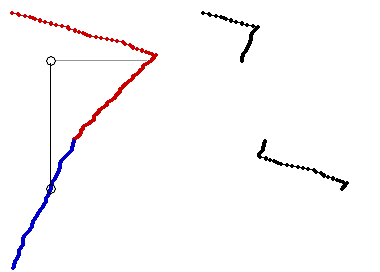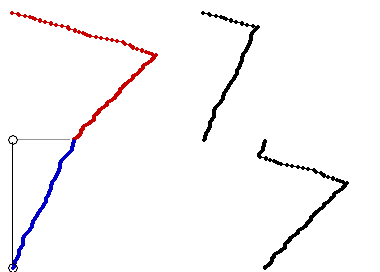
このようにいびつな形でも上下分離はできるようだ。
今度はルート記号のような形がでてきた。こんなんでも実は上下分離できる。
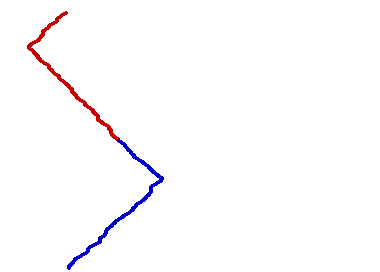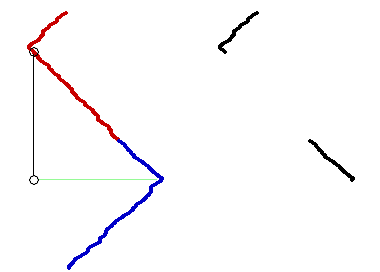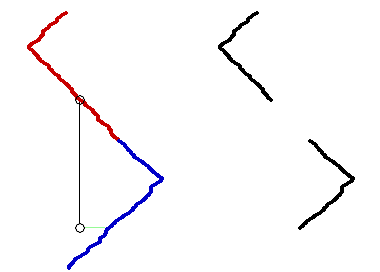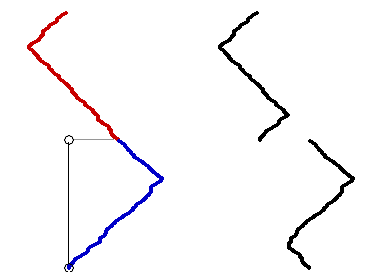
実はこの形のことをbitonic sequenceと呼ぶ。
https://en.wikipedia.org/wiki/Bitonic_sorter
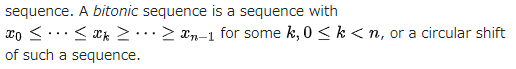
単調増加→単調減少となっている数列で、かつそれが循環シフトしていてもよい。
上の画像のルート記号を縦にしたような形は、よくみると赤の一番上の位置と青の一番下の位置が繋がっている。循環シフトすれば「ヘ」の字のように単調増加→単調減少の形になるはずだ。
結局のところ
バイトニックソートの内部構造を改めてみてみる。結局のところバイトニックソートは、bitonic sequenceを入力すると上下分離されたbitonic sequenceが出力され、それが次の入力になって・・・という形が続いているだけである。
なのである範囲内で集合の上下関係を確定させることが可能で、その結果最後はソートされた数列になっているというわけ。
改めて見るとなんだか美しい図に見えてくるなぁ
(余談1:美しいのには理由がありました。FFTバタフライ演算図と流れが酷似しています。)
(余談2:上のgifを作るのためにHSPでプログラムを書いて絵を出力しました。案外1-2時間程度で簡便に作れたので手短にかけるHSPは楽で良いです。)
バイトニックソートのGPU実装
GPU実装。まずどこを並列化できるかを探す。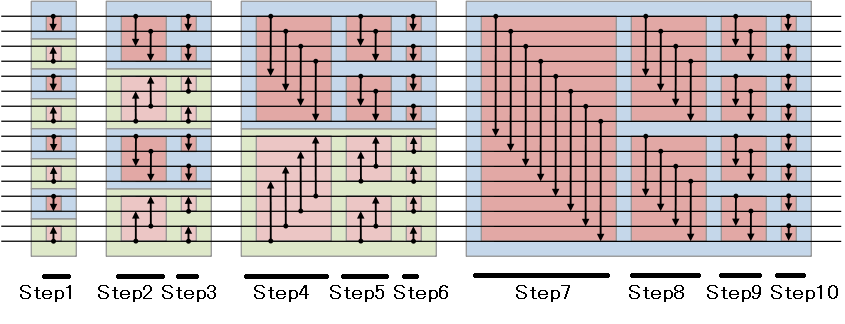
このようにStep分けすると、各Step内はほぼ同じような処理をしているためここを並列化できそうだ。
Step7を抽出してみると
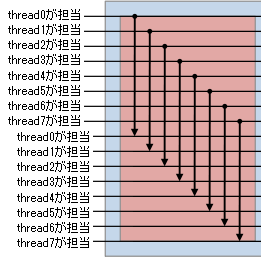
このように1threadが2点の比較をするように組むとして、あとは自threadがどの2点にアクセスするかの計算コードを書けば良い。
Unityで実装
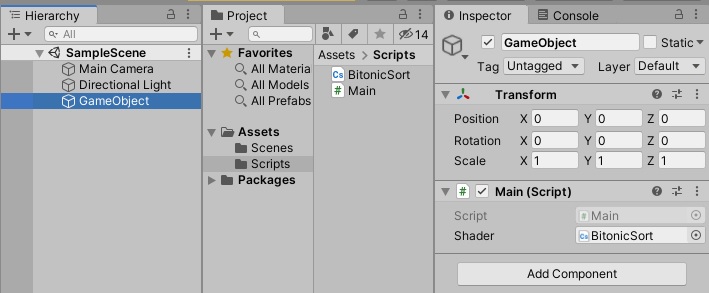
Unityを起動し空のGameObjectを作成
下記のMain.csをアタッチしBitonicSort.computeを紐づけ
C#(Main.cs)
using System;
using System.Collections;
using System.Collections.Generic;
using System.Runtime.InteropServices;
using UnityEngine;

//keyを配列index付きでソートする
public class Main : MonoBehaviour
{
    struct mystruct
    {
        public float key;//ソートしたい値
        public uint index;//一緒にソートされるindex
    }

    public ComputeShader shader;
    ComputeBuffer gpu_data;
    int kernel_ParallelBitonic;
    mystruct[] host_data;
    const int THREADNUM_X = 64;

    //配列の要素数
    int N = 1 << 19;//下限 1<<7,上限 1<<27

    void kernelfindStart()
    {
        kernel_ParallelBitonic = shader.FindKernel("ParallelBitonic");
    }

    void host_Init()
    {
        for (uint i = 0; i < N; i++)
        {
            host_data[i].key = UnityEngine.Random.Range(0.0f, 1.0f);
            host_data[i].index = i;
        }
    }

    void Start()
    {
        host_data = new mystruct[N];//ソートしたいデータ
        gpu_data = new ComputeBuffer(host_data.Length, Marshal.SizeOf(host_data[0]));

        //カーネル初期設定
        kernelfindStart();

        //CPU側で初期値代入
        host_Init();

        // host to device
        gpu_data.SetData(host_data);

        //ソート実装部分
        BitonicSort(gpu_data);
        gpu_data.GetData(host_data);

        //結果表示
        resultDebug();
    }

    void BitonicSort(ComputeBuffer gpu_data)
    {
        int n = gpu_data.count;
        //引数をセット
        shader.SetBuffer(kernel_ParallelBitonic, "data", gpu_data);

        int nlog = (int)(Mathf.Log(n, 2));
        int lninc, inc;

        for (int i = 0; i < nlog; i++)
        {
            inc = 1 << i;
            for (int j = 0; j < i + 1; j++)
            {
                shader.SetInt("inc", inc);
                shader.SetInt("dir", 2 << i);
                shader.Dispatch(kernel_ParallelBitonic, n / 2 / THREADNUM_X, 1, 1);
                inc /= 2;
            }
        }
    }

    void resultDebug()
    {
        // device to host
        gpu_data.GetData(host_data);

        Debug.Log("GPU上でソートした結果");
        for (int i = 0; i < Mathf.Min(1024, gpu_data.count); i++)
        {
            Debug.Log("index=" + host_data[i].index + " key=" + host_data[i].key);
        }
    }

    private void OnDestroy()
    {
        //解放
        gpu_data.Release();
    }
}
ComputeShader(BitonicSort.compute)
#pragma kernel ParallelBitonic

//構造体と比較を自前で定義する必要あり。
struct Mystruct
{
	float key;
	uint index;
};
#define data_t Mystruct
#define COMPARISON(a,b) ( a.key > b.key )
//ここまで

RWStructuredBuffer<data_t> data;
int inc;
int dir;

[numthreads(64, 1, 1)]
void ParallelBitonic(uint threadid : SV_DispatchThreadID)
{
	int t = threadid; // thread index
	int low = t & (inc - 1); // low order bits (below INC)
	int i = (t << 1) - low; // insert 0 at position INC
	bool reverse = ((dir & i) == 0); // asc/desc order

	// Load
	data_t x0 = data[i];
	data_t x1 = data[inc + i];

	// Sort
	bool swap = reverse ^ COMPARISON(x0, x1);
	data_t auxa = x0;
	data_t auxb = x1;
	if (swap) { x0 = auxb; x1 = auxa; }

	// Store
	data[i] = x0;
	data[inc + i] = x1;
}
結果
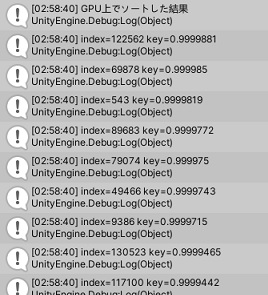
Key(float型)が大きい順にソートされている。
ソートする前のindexの情報も含んだ構造体でソートしているので、indexも一緒にソートできている。
この構造体はmystructで定義しているので一応自由に変えられる。
C#のmystructを変えたらComputeShader側のmystructも変える必要あり。
また、使用の注意点としてはソースコードにもあるよう、2のべき乗の要素数でしかソートできない。もし端数なら、-∞や+∞で数値を埋めておいてソート結果に影響しないようにしておく必要がある。
速度計測
単位はms| 要素数/カーネル名 | B2 |
|---|---|
| 256 | 0 |
| 512 | 0 |
| 1024 | 0 |
| 2048 | 0 |
| 4096 | 0 |
| 8192 | 0 |
| 16384 | 0 |
| 32768 | 0 |
| 65536 | 1 |
| 131072 | 1 |
| 262144 | 2 |
| 524288 | 4 |
| 1048576 | 10 |
| 2097152 | 19 |
| 4194304 | 39 |
| 8388608 | 83 |
| 16777216 | 179 |
| 33554432 | 382 |
| 67108864 | 818 |
| 134217728 | 1744 |
(1threadあたり2点読み込んでいるためと思われる。)
高速化Tips
これでも十分速いけど高速化はロマン!コアレスアクセス
UnityでGPGPUその2でさんざん書いてきたよう、コアレスアクセスは速い。上のコードではすでにコアレスアクセスはできているので特段変える必要はない。
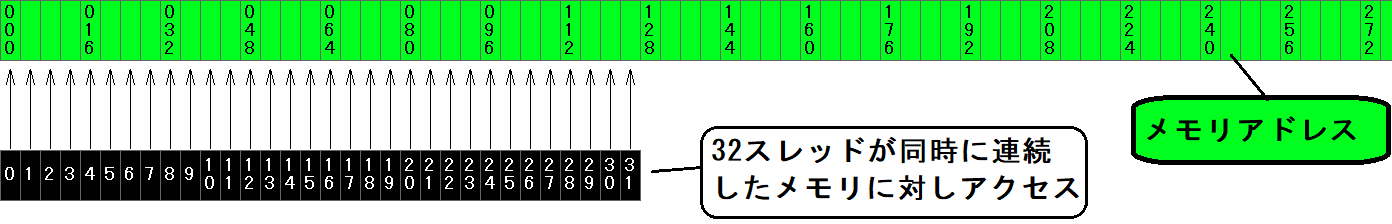
改めて図示するとこんな感じに、同じwarp(wavefront)が実行するカーネルはなるべく連続したメモリアドレスにアクセスするようにする。
Shared Memoryを使う
今までのコードは、1threadがグローバルメモリの2か所を読み取って比較し、適宜swapした後またメモリに書き戻す、という作業をしていた。このグローバルメモリはいくらコアレスアクセスができてもなお遅いので可能な限りグローバルメモリを介さず計算したいと考える。そこでShared Memoryを使えないかと考える。1Gruopあたり16threadだとするとその16threadはshared memoryを共有できる。
バイトニックソートのアルゴリズム図をもっと遠くからみた図
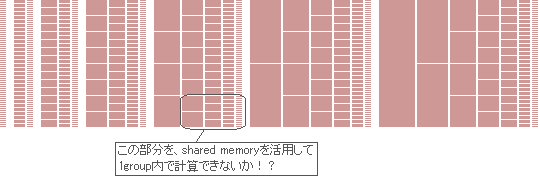
各Stepで結果をグローバルメモリにいちいち書き戻さなくても、shared memoryに書き込んで使いまわしていくことで、グローバルメモリにアクセスするのはカーネルの最初と最後だけにすることができる。
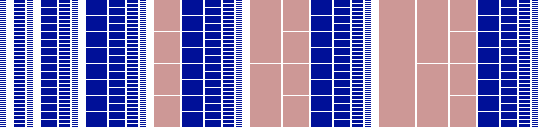
この青のところが全部shared memoryで高速化できるところだ!
ここでは図示しやすいように1Group=16threadで書いているが、実際は1Group=64threadや1Group=128threadで実装している。
これをやることで
| 要素数/カーネル名 | B2 | B2C2 |
|---|---|---|
| 256 | 0 | 0 |
| 512 | 0 | 0 |
| 1024 | 0 | 0 |
| 2048 | 0 | 0 |
| 4096 | 0 | 0 |
| 8192 | 0 | 0 |
| 16384 | 0 | 0 |
| 32768 | 0 | 0 |
| 65536 | 1 | 0 |
| 131072 | 1 | 1 |
| 262144 | 2 | 1 |
| 524288 | 4 | 3 |
| 1048576 | 10 | 8 |
| 2097152 | 19 | 11 |
| 4194304 | 39 | 24 |
| 8388608 | 83 | 51 |
| 16777216 | 179 | 109 |
| 33554432 | 382 | 236 |
| 67108864 | 818 | 508 |
| 134217728 | 1744 | 1095 |
1.5-6倍速くなった!
2Step同時計算
上図のピンク領域はShared Memoryにおさまりきらないので、従来のグローバルメモリに読み書きする方式でやっている。今度はそこを高速化しようという話。従来はthread0~thread7がそれぞれ2点ずつ読み込んで、という処理だったが
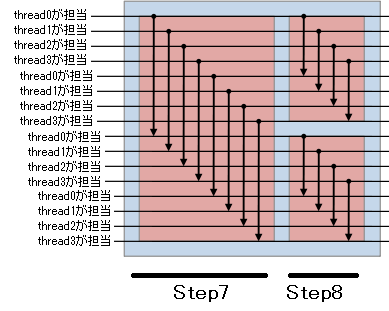
今度はthread0~thread3がそれぞれ4点のメモリを読み込んで2Step分まとめて計算しようという発想だ。
従来の方法だと
Step7を計算するのに必要なメモリアクセス回数が、Load16回+Store16回、そしてStep8を計算するのにLoad16回+Store16回で合計64回の読み書きが発生していた。
しかし2Step同時計算をすることでLoad16回+Store16回で合計32回の読み書きで済む。
こうしてグローバルメモリのアクセス回数を減らしていくことで高速化をしていく。
| 要素数/カーネル名 | B2 | B2C2 | B2B4C2 |
|---|---|---|---|
| 256 | 0 | 0 | 0 |
| 512 | 0 | 0 | 0 |
| 1024 | 0 | 0 | 0 |
| 2048 | 0 | 0 | 0 |
| 4096 | 0 | 0 | 0 |
| 8192 | 0 | 0 | 0 |
| 16384 | 0 | 0 | 0 |
| 32768 | 0 | 0 | 0 |
| 65536 | 1 | 0 | 0 |
| 131072 | 1 | 1 | 0 |
| 262144 | 2 | 1 | 1 |
| 524288 | 4 | 3 | 2 |
| 1048576 | 10 | 8 | 6 |
| 2097152 | 19 | 11 | 9 |
| 4194304 | 39 | 24 | 19 |
| 8388608 | 83 | 51 | 38 |
| 16777216 | 179 | 109 | 77 |
| 33554432 | 382 | 236 | 163 |
| 67108864 | 818 | 508 | 345 |
| 134217728 | 1744 | 1095 | 735 |
最初から2倍以上速くなった!
n Step同時計算
ではStepを3つや4つまとめて計算すればもっと良いのではという発想が出るのは自然なことだ。しかし4つまとめて、とやると1threadあたりの作業量が16点になり、5つで32点・・・と指数的に増えていってしまう。さすがにレジスタの容量も限られているので4Stepまとめくらいが限度だろう。
OpenCLのサイトの実装も4Stepまでであった。
| 要素数/カーネル名 | B2 | B2C2 | B2B4C2 | B2B4B8C2 | B2B4B8B16C2 |
|---|---|---|---|---|---|
| 256 | 0 | 0 | 0 | 0 | 0 |
| 512 | 0 | 0 | 0 | 0 | 0 |
| 1024 | 0 | 0 | 0 | 0 | 0 |
| 2048 | 0 | 0 | 0 | 0 | 0 |
| 4096 | 0 | 0 | 0 | 0 | 0 |
| 8192 | 0 | 0 | 0 | 0 | 0 |
| 16384 | 0 | 0 | 0 | 0 | 0 |
| 32768 | 0 | 0 | 0 | 0 | 0 |
| 65536 | 1 | 0 | 0 | 0 | 0 |
| 131072 | 1 | 1 | 0 | 0 | 0 |
| 262144 | 2 | 1 | 1 | 1 | 1 |
| 524288 | 4 | 3 | 2 | 2 | 2 |
| 1048576 | 10 | 8 | 6 | 6 | 5 |
| 2097152 | 19 | 11 | 9 | 11 | 8 |
| 4194304 | 39 | 24 | 19 | 16 | 16 |
| 8388608 | 83 | 51 | 38 | 33 | 33 |
| 16777216 | 179 | 109 | 77 | 68 | 63 |
| 33554432 | 382 | 236 | 163 | 139 | 127 |
| 67108864 | 818 | 508 | 345 | 292 | 271 |
| 134217728 | 1744 | 1095 | 735 | 614 | 556 |
効果はかなりあるようだ。
ここまでの高速化Tipsを全て踏まえ、さらにShared memory内の計算にも2Step同時計算を適応したコードを適応すると
| 要素数/カーネル名 | B2 | B2B4B8B16C2 | B2B4B8B16C2C4 |
|---|---|---|---|
| 256 | 0 | 0 | 0 |
| 512 | 0 | 0 | 0 |
| 1024 | 0 | 0 | 0 |
| 2048 | 0 | 0 | 0 |
| 4096 | 0 | 0 | 0 |
| 8192 | 0 | 0 | 0 |
| 16384 | 0 | 0 | 0 |
| 32768 | 0 | 0 | 0 |
| 65536 | 1 | 0 | 0 |
| 131072 | 1 | 0 | 0 |
| 262144 | 2 | 1 | 1 |
| 524288 | 4 | 2 | 2 |
| 1048576 | 10 | 5 | 5 |
| 2097152 | 19 | 8 | 7 |
| 4194304 | 39 | 16 | 14 |
| 8388608 | 83 | 33 | 29 |
| 16777216 | 179 | 63 | 60 |
| 33554432 | 382 | 127 | 127 |
| 67108864 | 818 | 271 | 264 |
| 134217728 | 1744 | 556 | 552 |
これはあまり速くならなかったが気持ち少し速くなっている!
ともあれ最初と比べ3.16倍になった。高速化は大成功!!実行メモリバンド幅測定
このベンチマークをとったのはRTX2080Ti。このGPUのメモリのバンド幅は616GB/s。B2B4B8B16C2C4カーネルで要素数最大の134217728でやった場合のメモリアクセス量は82回*2回×134217728*8byte=176.1GB
これを1秒あたりに直して319GB/sの実行メモリバンド幅とわかる。
約51.8%の性能が出せている。個人的には十分だと思う。
行列転置で全範囲Sared memory化
ここからは自分オリジナルの案になるが、結論から言うと速くならなかった。発想としてはFFTのブロック化の案(参考pdf)を使うことで、メモリアクセスの局所化をはかる。
これを
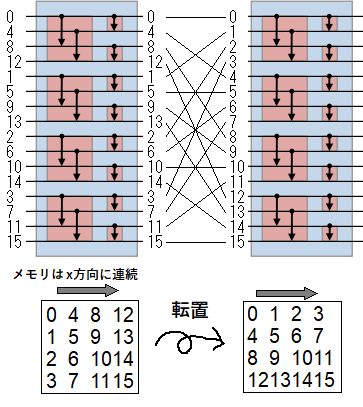
こうする。
なお、書いてある数字はメモリの中身ではなくメモリアドレスだと思ってほしい。
このアルゴリズム図はメモリレイアウトが変わっただけで、今までと全く同じことをしている。
違うのは各Stepを計算するとき、メモリアクセスが4領域内にまとめられているということ。
画像でいうと最初の処理で(0,4,8,12)、(1,5,9,13)、(2,6,10,14)、(3,7,11,15)にまとめてアクセスしており、後半処理では(0,1,2,3)、(4,5,6,7)、(8,9,10,11)、(12,13,14,15)にまとめてアクセスしている。この「まとまっている」がコアレスアクセスに相当する。
最初の処理では(0,4,8,12)と飛び飛びだからコアレスアクセスできてないと思うかもしれないが、事前に行列転置をしておくことで可能になる。
GPUを使った行列転置は記事にしたのでこれを参考に(パディングなしでバンクコンフリクトを解消する方法 CUDA 行列転置)
最初0,1,2,3,4,5,6,7,8,9,10,11,12,13,14,15の順だったのを0,4,8,12,1,5,9,13,2,6,10,14,3,7,11,15に効率的に配置できる。同じように0,4,8,12,1,5,9,13,2,6,10,14,3,7,11,15から0,1,2,3,4,5,6,7,8,9,10,11,12,13,14,15へも効率的に配置できる(これは画像の通り)。
この行列転置はShared memoryを使うことで読み書きともにコアレスアクセスにできる。
これで何が嬉しいかと言うと、今までShared memoryに入りきらなかったStepの計算もすべてShared memoryを使いつつコアレスアクセスにできることである。
イメージとしてはこうなる。
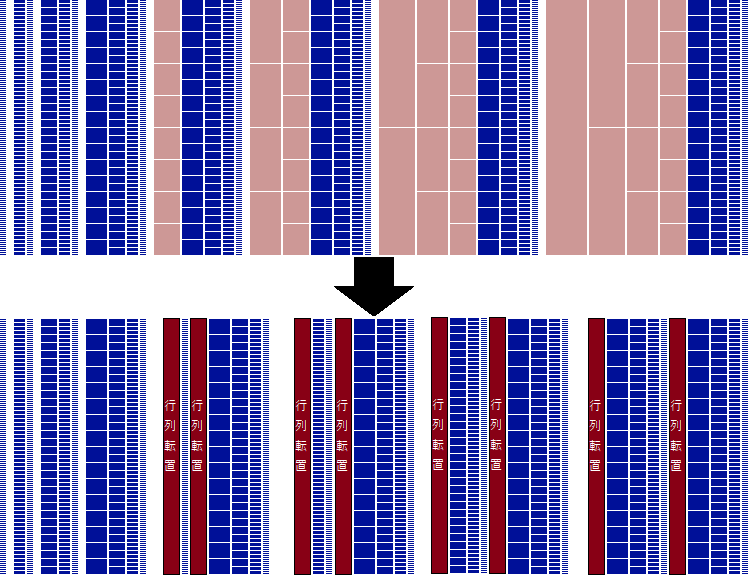
Shared memoryを使った計算では8Stepまとめて計算できるので、今までの4Step+4Stepの処理が1つにまとまる。しかしその分行列転置の処理が入り込むので結局メモリアクセス量はたいして変わらずかむしろ増えたようで、Totalの速度ではむしろ1.2倍くらい遅くなってしまった。
なおShared memoryの容量的にまだ余裕があったので10Stepまとめて計算するコードに変えてみたが意外と速くならなかった。なかなか高速化は難しい・・・。
Shared memoryだけ使わないと
環境によってはShared memoryが使えないという状況もあると思い追加で速度測定B2B4B8B16というやつ
| 要素数/カーネル名 | B2 | B2C2 | B2B4B8B16C2C4 | B2B4B8B16 |
|---|---|---|---|---|
| 256 | 0 | 0 | 0 | 0 |
| 512 | 0 | 0 | 0 | 0 |
| 1024 | 0 | 0 | 0 | 0 |
| 2048 | 0 | 0 | 0 | 0 |
| 4096 | 0 | 0 | 0 | 0 |
| 8192 | 0 | 0 | 0 | 0 |
| 16384 | 0 | 0 | 0 | 0 |
| 32768 | 0 | 0 | 0 | 0 |
| 65536 | 1 | 0 | 0 | 0 |
| 131072 | 1 | 1 | 0 | 0 |
| 262144 | 2 | 1 | 1 | 1 |
| 524288 | 4 | 3 | 2 | 1 |
| 1048576 | 10 | 8 | 5 | 4 |
| 2097152 | 19 | 11 | 7 | 9 |
| 4194304 | 39 | 24 | 14 | 18 |
| 8388608 | 83 | 51 | 29 | 36 |
| 16777216 | 179 | 109 | 60 | 73 |
| 33554432 | 382 | 236 | 127 | 154 |
| 67108864 | 818 | 508 | 264 | 322 |
| 134217728 | 1744 | 1095 | 552 | 670 |
1.2倍ほど遅くなったがこれでも十分すぎるほど速いのではないか。
参考文献
一番参考にしたやつOpenCL版
WebGL2でGPGPUバイトニックソート【Qiita】Compute Shaderでのソートアルゴリズムの処理時間比較
【Qiita】ComputeShaderで近傍探索の高速化
※本ブログで紹介しているソースコードはすべてCC0 パブリックドメインです。
ご自由にお使いください
前