

のんびりと更新を続けて、今回でやっとライブドアブログ移転2回目の記事
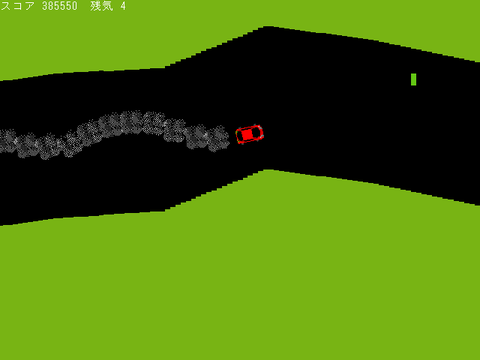
まずHSPコンテストのことだが、今年は作成時間がとても少なく、締め切り直前にあたふたした感が否めない。
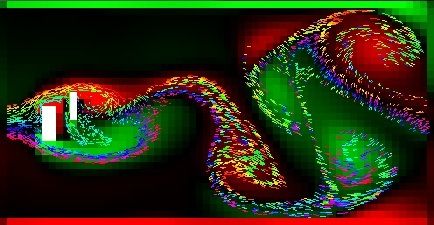
この前の記事で構想を温めていると自慢したはずの流体力学は、10/31日時点で全く自分の思い描いていた形に仕上げられないままであった。
今年の投稿は諦めるかと悩んだが、ブログの方でHSPで高速な演算ができることに期待をしているコメントを頂いていたことか後押しして、投稿することにした。
実際、自分にとってこの大きな発見を、一年も後に発表を引き延ばすことは耐えられるか危うかった。
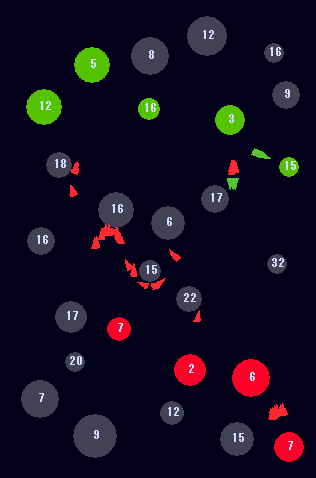
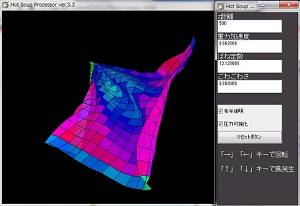
投稿直前の10分でとりあえず動く形にして、付属として入れるはずだったリアルタイムレイトレーシングの方が完成度が高かったので、仕方なくそっちをメインということにしてサムネも作成した。
本当は「HSPでGPGPU」という名前にしたかったのだが、パソコンの時計を見たらもう58分になっていて、焦ってシフトキーを押す手が震えてしまい全部小文字になってしまった・・・
それとHSPでGPGPUは実はHLSLでGPGPUだった件
結局UPしたのは0:00を30秒くらいオーバーしていた・・・がなんとか受け付けてもらえたようだ。
そのような経緯があって、内容説明文や何から何まで完成度が1%となった。
本当はリアルタイムで数値流体力学シミュして、ゲームみたいに遊べるようにしたかったのだが。
そして11/18正午・・・、一次審査通過が決定!落ちた人には申し訳ないが、嬉しいけどこれじゃ不甲斐ない・・まぁ言い訳してもみっともない
来年こそは、時間たっぷりかけて作品を仕上げてやる!
また、参加者の作品を何十個か遊んでみたのだが、こういうゲーム自分もいつか作りたいと思ってたんだよねーというものが多く、各々自分の創造力を大切にしながらゲームを作っているなと言った感じだった。
やっぱりHSPコンテストの意義と言うか、最終目標は『HSPでこんなことが出来るのか!すげぇ!』という感動を初見に、あわよくば既存のユーザーにも与えるという事だと思う。
今年はそんな「すげぇ」と言わせてくれるような作品が多かったように思えるし、「将来すげぇものに化けそうだな」というような作品を作ってくる人も多かった。
私も少しながら、評価コメントの方で「すごい」と言わせられたので当面の目標は達成したかなと思っている。
さて本題だ
HLSLのピクセルシェーダを使って、512×512ピクセルのスクリーンにリアルタイムレイトレーシングをする方法だが、その手順を書いていこうと思う。
前提としてHSPがインストールされていることと、easy3Dのver5.2.3.3が入っていることが条件。(なぜeasy3Dの過去バージョンを使っているかは後述)
今回もいきなりLEVEL100のモンスターを倒すようなマネはしないで、しっかりLEVEL1から、一番敷居の低いアルゴリズムで基礎の基礎からはじめていこう~!
【導入・・・的な】
レイトレのアルゴリズムといえば、
(1)視線は、スクリーン上のある画素を通って物体方向に向かう。この視線と交差する別の物体があるかどうか調べる。
(2)交差する物体が存在するなら、視線と物体との交点を求める。交差する物体が複数ある場合には、すべての物体について交点を求める。交点がない場合には背景の色とする。
(3)視線と交点との距離を求め、最も視点に近い物体を抽出する(隠面消去したことになる)。
(4)可視物体の輝度の計算をする。このとき、光源と交点を結ぶ線分と交差する物体を調べ、影の有無を判定する。
(5)反射・屈折がある物体なら、反射方向、屈折方向を求め、これらの方向を視線とみなして②③の処理を行い、屈折・反射して見える物体を抽出する。
以上の処理をスクリーン上のすべての画素について行う。
(5)の処理では、視線(レイ)と交差する物体が不透明物体の場合には、陰影計算によって物体の色を計算し、画素に塗る。一方、鏡面のような反射面に視線が交差した場合には、さらに反射方向を追跡する。また透明物体の場合には、屈折方向も追跡する。反射と屈折方向の両方を求める必要がある場合が多い。光線の反射や屈折方向を求めるには、その面の向き(すなわち法線)を求める必要がある。また、屈折方向を求めるには、法線方向のみだけではなく、その物体の屈折率が必要である。視線が反射と屈折の2本の線に分岐することから、追跡経路は2分木表現される。
と
http://www.rsch.tuis.ac.jp/~naka/naka/scola/member/chapter5_html/chapter5.html
に解説してあるとおりで間違いない。
だがこれはいわばLEVEL50くらい手強いモンスターである。
ここからLEVEL1に下げて考えるには徹底的に簡略化する必要がある。
まず(1)は削る所がない。
(2)は、物体の形で交点を求めるプログラムが変わってくるが、ここは一番簡単な「球」の1種類でいいだろう。
背景色は最後の視線の方向で色と明るさ決定。(単色はダメ)
(3)ここも削る所がない。
(4)影の有無は面倒なので消去。(全て影なしとして計算)
(5)反射はあってもよいが、屈折は屈折率とかで面倒。光の吸収率も面倒なので100%光が反射するという設定でいこう。これで不気味な2分木とかいう経路演算は必要なくなる。これで相当簡単になるはず。
さらにレイトレではなぜかチェック模様の地面があるのが普通とされているのだが、地面と視線との当たり判定がコレまた面倒なので地面も取っ払い、球だけの世界で良しとすればどうだろう・・LEVEL1近くなったんじゃなかろうか
この方法をフローチャートにまとめるとこうなる。

うん。かなり簡素化したな
ここで視線ベクトルと視点(位置)ベクトルは、それぞれ以下のベクトルtV、Mのこととして考えて欲しい。

【テクスチャの準備】
GPGPUをやるということは、テクスチャを変数に見立てるということに他ならない。
ここで、レイトレで必要な変数と要素数を全てあげると、
・球の位置座標(x、y、z)と球の半径r = 4×球の数
・視点ベクトルM(x、y、z成分) = 3×全画素数
・視線ベクトルtV(tx、ty、tz成分) = 3×全画素数
tは上の図で言うカメラの位置から交点までの距離。
・視線と交差した球の識別IDを格納する変数 = 1×全画素数
・レンダリング用のバッファのr、g、b成分 = 3×全画素数
だ。
E3DCreateRenderTargetTexture命令で、テクスチャフォーマットはA32B32G32R32Fにしてバッファを作ると、
1ピクセルにR,G,B,Aの4つの情報を格納できる。さらに一つ一つの精度は単精度floatでレイトレには十分といえる精度だ。
さて上の変数をテクスチャ数がなるべく少なくなるように格納すると
・球の数だけ画素があるテクスチャ ×1枚 : 球の位置x、y、z、半径rを格納
・512×512ピクセルのテクスチャ ×3枚 : tV(tx,ty,tz)とIDで1枚(①)。M(x,y,z)で1枚(②)。レンダリングバッファのr、g、bで1枚(③)
ということで4枚のGPUバッファを用意すればいいことになる。
百聞は一見にしかずだ
32個の球の情報を格納したテクスチャは

こんなこんじだ。(大きさは64×64ピクセル)(節約しようと思えば8×8のバッファで事足りるが・・)
【フローチャート】
また、下の図は2枚+レンダリング用バッファのテクスチャを、レイトレーシングが完結するまでの各タイムステップごとにキャプチャしたものである。


マイナスの値は0にクランプされて表示されているが、クランプされているのは表示の方だけである。
(A)の②

ここではまだ、球との当たり判定をしていないので、位置ベクトル=カメラの位置=(0,0,-7)で真っ暗な画像になっている。
(B)の①

フローチャートで言うと2番目
「球と視線の交点を求める」
全ての球について当たり判定を行なう。
まず、一つ目の球でt1V(t1x,t1y,t1z)を求める。
これをr,g,b成分に代入するのだが、t1Vの解が求まらない場合(つまり交点がない場合)は代入を無視。
次に二つ目の球でt2V(t2x,t2y,t2z)を求める。
t1>t2なら代入。t1の値はr,g,b成分から求めればいい。( t1=sqrt(r*r+g*g+b*b) )
これを全ての球で行ない、最終的に一番近い交点への視線ベクトルが代入されたことになる。
そしてこの画像は全ての球との当たり判定後の状態。
球のところが黒く抜けているが、これは黒い部分に代入されているベクトル情報が例えば12.1×(x,y,z)みたくなっているので、無限遠に飛ぶ65536×(x,y,z)と比べて値がとても小さい → 相対的に黒く見える、という状態だ。(ここで(x,y,z)は単位ベクトルである)
(C)の②

フローチャートで言うと3番目
「一番近い交点を視点ベクトルに代入」
交点がない場合、それまでの値は保持されたまま。
という訳で、視点ベクトルに代入された結果が(C)②
(C)の①

フローチャート4番目の「反射ベクトルを視点ベクトルに代入」
反射ベクトルの求め方はココで解説したとおり。
以降フローチャートの2~4が3回ループして、反射回数が増えていく・・・
(I)の③

フローチャートの5番
「最後の視線の方向で背景色決定」
3回反射処理した結果、全ての画素の視線の先に球はなく、無限遠の背景が残るのみとなったら、視線ベクトルから背景色を決定する。
ここで、ライト(光源)ベクトルがあると便利である。
光源ベクトルと視線ベクトルの内積で1.0~-1.0の値が得られ、1.0が明るい水色の空、-1.0が暗い灰水色の空としてrgbを決定すれば意外とリアルな空になるはずである。
最後に少し応用で、新たに変数を作り反射した回数を記憶させておけば、反射による光の半減も再現できる。
あいにく視点(位置) ベクトルを格納しているテクスチャにはa成分だけ空きがある。
③の列のレンダリング画像は、実はその光の半減を取り入れている。
ひと通りフローチャート説明がこれで終了
カスタムシェーダは自分でくんでもらうとして 、とりあえずHSPでeasy3Dを介したHLSLによるリアルタイムレイトレーシングはこんな感じで動いている。
カスタムシェーダのソースとHSPのソースは
http://loda.jp/babadom/?id=114
からダウンロードできる。
だがこのソースははっきり言ってまだまだ改良の余地がありまくる。
今回の方法では、全てのドットで同じ処理をしないといけない制約があるので
例えば1ループ目ですでに球との交点がないドットでも、3ループ目まで当たり判定の処理をし続けないといけない。
だから全体的に無駄な処理が多い。
逆にまだまだ高速化が期待できるというわけだ。
どこまで挑戦できるか分からないが、飽くなき高速化への道はまだまだ続きそうだ。
ところでもしグラフィックボードが32bit浮動小数点の計算に対応していないとどうなるのか・・・
一応起動して、16bit浮動小数点のテクスチャで計算されるらしい。
だが少し計算にズレが生じるらしく、完成画像が少し荒くなる↓

あと前半の方でeasy3Dのバージョンが 5.2.3.3 を使用しないといけないと書いてあるが、
始めに「hspでgpgpu」を知り合いのパソコンで起動してもらおうとしたらなぜか起動しなく、その時easy3D.dllの最新バージョンを使っていた。
逆にインストール不要形式のバージョン 5.2.3.3で試してみたら動いたので、こちらを推奨しているというわけ
ちなみにその人のパソコンはwindows7でかなり最新のノートパソコンなのでDirectxは10以上だった気がするから、起動しなかった原因はよくわからない・・おちゃっこさん究明お願いします。
次回:流体力学のプログラムを作りたい!その2
PS
なんかコンテストTVに「hspでgpgpu」が紹介されてました!!審査員の方々ありがとうございます!!
あと2日で最終選考の結果が発表ですね。楽しみです
まずHSPコンテストのことだが、今年は作成時間がとても少なく、締め切り直前にあたふたした感が否めない。
この前の記事で構想を温めていると自慢したはずの流体力学は、10/31日時点で全く自分の思い描いていた形に仕上げられないままであった。
今年の投稿は諦めるかと悩んだが、ブログの方でHSPで高速な演算ができることに期待をしているコメントを頂いていたことか後押しして、投稿することにした。
実際、自分にとってこの大きな発見を、一年も後に発表を引き延ばすことは耐えられるか危うかった。
投稿直前の10分でとりあえず動く形にして、付属として入れるはずだったリアルタイムレイトレーシングの方が完成度が高かったので、仕方なくそっちをメインということにしてサムネも作成した。
本当は「HSPでGPGPU」という名前にしたかったのだが、パソコンの時計を見たらもう58分になっていて、焦ってシフトキーを押す手が震えてしまい全部小文字になってしまった・・・
結局UPしたのは0:00を30秒くらいオーバーしていた・・・がなんとか受け付けてもらえたようだ。
そのような経緯があって、内容説明文や何から何まで完成度が1%となった。
本当はリアルタイムで数値流体力学シミュして、ゲームみたいに遊べるようにしたかったのだが。
そして11/18正午・・・、一次審査通過が決定!落ちた人には申し訳ないが、嬉しいけどこれじゃ不甲斐ない・・まぁ言い訳してもみっともない
来年こそは、時間たっぷりかけて作品を仕上げてやる!
また、参加者の作品を何十個か遊んでみたのだが、こういうゲーム自分もいつか作りたいと思ってたんだよねーというものが多く、各々自分の創造力を大切にしながらゲームを作っているなと言った感じだった。
やっぱりHSPコンテストの意義と言うか、最終目標は『HSPでこんなことが出来るのか!すげぇ!』という感動を初見に、あわよくば既存のユーザーにも与えるという事だと思う。
今年はそんな「すげぇ」と言わせてくれるような作品が多かったように思えるし、「将来すげぇものに化けそうだな」というような作品を作ってくる人も多かった。
私も少しながら、評価コメントの方で「すごい」と言わせられたので当面の目標は達成したかなと思っている。
さて本題だ
HLSLのピクセルシェーダを使って、512×512ピクセルのスクリーンにリアルタイムレイトレーシングをする方法だが、その手順を書いていこうと思う。
前提としてHSPがインストールされていることと、easy3Dのver5.2.3.3が入っていることが条件。(なぜeasy3Dの過去バージョンを使っているかは後述)
今回もいきなりLEVEL100のモンスターを倒すようなマネはしないで、しっかりLEVEL1から、一番敷居の低いアルゴリズムで基礎の基礎からはじめていこう~!
【導入・・・的な】
レイトレのアルゴリズムといえば、
(1)視線は、スクリーン上のある画素を通って物体方向に向かう。この視線と交差する別の物体があるかどうか調べる。
(2)交差する物体が存在するなら、視線と物体との交点を求める。交差する物体が複数ある場合には、すべての物体について交点を求める。交点がない場合には背景の色とする。
(3)視線と交点との距離を求め、最も視点に近い物体を抽出する(隠面消去したことになる)。
(4)可視物体の輝度の計算をする。このとき、光源と交点を結ぶ線分と交差する物体を調べ、影の有無を判定する。
(5)反射・屈折がある物体なら、反射方向、屈折方向を求め、これらの方向を視線とみなして②③の処理を行い、屈折・反射して見える物体を抽出する。
以上の処理をスクリーン上のすべての画素について行う。
(5)の処理では、視線(レイ)と交差する物体が不透明物体の場合には、陰影計算によって物体の色を計算し、画素に塗る。一方、鏡面のような反射面に視線が交差した場合には、さらに反射方向を追跡する。また透明物体の場合には、屈折方向も追跡する。反射と屈折方向の両方を求める必要がある場合が多い。光線の反射や屈折方向を求めるには、その面の向き(すなわち法線)を求める必要がある。また、屈折方向を求めるには、法線方向のみだけではなく、その物体の屈折率が必要である。視線が反射と屈折の2本の線に分岐することから、追跡経路は2分木表現される。
と
http://www.rsch.tuis.ac.jp/~naka/naka/scola/member/chapter5_html/chapter5.html
に解説してあるとおりで間違いない。
だがこれはいわばLEVEL50くらい手強いモンスターである。
ここからLEVEL1に下げて考えるには徹底的に簡略化する必要がある。
まず(1)は削る所がない。
(2)は、物体の形で交点を求めるプログラムが変わってくるが、ここは一番簡単な「球」の1種類でいいだろう。
背景色は最後の視線の方向で色と明るさ決定。(単色はダメ)
(3)ここも削る所がない。
(4)影の有無は面倒なので消去。(全て影なしとして計算)
(5)反射はあってもよいが、屈折は屈折率とかで面倒。光の吸収率も面倒なので100%光が反射するという設定でいこう。これで不気味な2分木とかいう経路演算は必要なくなる。これで相当簡単になるはず。
さらにレイトレではなぜかチェック模様の地面があるのが普通とされているのだが、地面と視線との当たり判定がコレまた面倒なので地面も取っ払い、球だけの世界で良しとすればどうだろう・・LEVEL1近くなったんじゃなかろうか
この方法をフローチャートにまとめるとこうなる。
うん。かなり簡素化したな
ここで視線ベクトルと視点(位置)ベクトルは、それぞれ以下のベクトルtV、Mのこととして考えて欲しい。
【テクスチャの準備】
GPGPUをやるということは、テクスチャを変数に見立てるということに他ならない。
ここで、レイトレで必要な変数と要素数を全てあげると、
・球の位置座標(x、y、z)と球の半径r = 4×球の数
・視点ベクトルM(x、y、z成分) = 3×全画素数
・視線ベクトルtV(tx、ty、tz成分) = 3×全画素数
tは上の図で言うカメラの位置から交点までの距離。
・視線と交差した球の識別IDを格納する変数 = 1×全画素数
・レンダリング用のバッファのr、g、b成分 = 3×全画素数
だ。
E3DCreateRenderTargetTexture命令で、テクスチャフォーマットはA32B32G32R32Fにしてバッファを作ると、
1ピクセルにR,G,B,Aの4つの情報を格納できる。さらに一つ一つの精度は単精度floatでレイトレには十分といえる精度だ。
さて上の変数をテクスチャ数がなるべく少なくなるように格納すると
・球の数だけ画素があるテクスチャ ×1枚 : 球の位置x、y、z、半径rを格納
・512×512ピクセルのテクスチャ ×3枚 : tV(tx,ty,tz)とIDで1枚(①)。M(x,y,z)で1枚(②)。レンダリングバッファのr、g、bで1枚(③)
ということで4枚のGPUバッファを用意すればいいことになる。
百聞は一見にしかずだ
32個の球の情報を格納したテクスチャは
こんなこんじだ。(大きさは64×64ピクセル)(節約しようと思えば8×8のバッファで事足りるが・・)
【フローチャート】
また、下の図は2枚+レンダリング用バッファのテクスチャを、レイトレーシングが完結するまでの各タイムステップごとにキャプチャしたものである。


縦を①~③で区切って、横を(A)~(I)で区切ったとして
(A)は初期視線ベクトルを代入した時点での画像で、(I)は完成時の画像
①の列の画像は ・・まぁ書いてあるが・・ 視線ベクトル(x、y、z)成分がこの画像のr、g、bに対応してある。4つめの成分であるaの情報は割愛してある(表現できないし)
(A)の①

フローチャートで言うと一番上
「視点、視線ベクトルxyz成分決定」
最初に飛ばす視線ベクトルtVを決定する。初期視点ベクトルMは全画素同値。
最初のtVは無限遠の空に飛んでいく視線なので
ここではtをできるだけ大きい数にとるのが理想(実際は65536を格納)
青地に、左が赤、上が緑っぽいグラデーションがかかっているのが分かるであろうか
赤はrつまりxの値が高いということを表している。
緑はgつまりyの値が高いということを表している。
赤い部分は、視線ベクトルが左方向に傾いていることを表している。
緑色の部分は、視線ベクトルが上方向に傾いていることを表している。
青はz方向なので手前から奥に向かう視線であることを表している。(A)は初期視線ベクトルを代入した時点での画像で、(I)は完成時の画像
①の列の画像は ・・まぁ書いてあるが・・ 視線ベクトル(x、y、z)成分がこの画像のr、g、bに対応してある。4つめの成分であるaの情報は割愛してある(表現できないし)
(A)の①
フローチャートで言うと一番上
「視点、視線ベクトルxyz成分決定」
最初に飛ばす視線ベクトルtVを決定する。初期視点ベクトルMは全画素同値。
最初のtVは無限遠の空に飛んでいく視線なので
ここではtをできるだけ大きい数にとるのが理想(実際は65536を格納)
青地に、左が赤、上が緑っぽいグラデーションがかかっているのが分かるであろうか
赤はrつまりxの値が高いということを表している。
緑はgつまりyの値が高いということを表している。
赤い部分は、視線ベクトルが左方向に傾いていることを表している。
緑色の部分は、視線ベクトルが上方向に傾いていることを表している。
マイナスの値は0にクランプされて表示されているが、クランプされているのは表示の方だけである。
(A)の②
ここではまだ、球との当たり判定をしていないので、位置ベクトル=カメラの位置=(0,0,-7)で真っ暗な画像になっている。
(B)の①
フローチャートで言うと2番目
「球と視線の交点を求める」
全ての球について当たり判定を行なう。
まず、一つ目の球でt1V(t1x,t1y,t1z)を求める。
これをr,g,b成分に代入するのだが、t1Vの解が求まらない場合(つまり交点がない場合)は代入を無視。
次に二つ目の球でt2V(t2x,t2y,t2z)を求める。
t1>t2なら代入。t1の値はr,g,b成分から求めればいい。( t1=sqrt(r*r+g*g+b*b) )
これを全ての球で行ない、最終的に一番近い交点への視線ベクトルが代入されたことになる。
そしてこの画像は全ての球との当たり判定後の状態。
球のところが黒く抜けているが、これは黒い部分に代入されているベクトル情報が例えば12.1×(x,y,z)みたくなっているので、無限遠に飛ぶ65536×(x,y,z)と比べて値がとても小さい → 相対的に黒く見える、という状態だ。(ここで(x,y,z)は単位ベクトルである)
(C)の②
フローチャートで言うと3番目
「一番近い交点を視点ベクトルに代入」
交点がない場合、それまでの値は保持されたまま。
という訳で、視点ベクトルに代入された結果が(C)②
(C)の①
フローチャート4番目の「反射ベクトルを視点ベクトルに代入」
反射ベクトルの求め方はココで解説したとおり。
以降フローチャートの2~4が3回ループして、反射回数が増えていく・・・
(I)の③
フローチャートの5番
「最後の視線の方向で背景色決定」
3回反射処理した結果、全ての画素の視線の先に球はなく、無限遠の背景が残るのみとなったら、視線ベクトルから背景色を決定する。
ここで、ライト(光源)ベクトルがあると便利である。
光源ベクトルと視線ベクトルの内積で1.0~-1.0の値が得られ、1.0が明るい水色の空、-1.0が暗い灰水色の空としてrgbを決定すれば意外とリアルな空になるはずである。
最後に少し応用で、新たに変数を作り反射した回数を記憶させておけば、反射による光の半減も再現できる。
あいにく視点(位置) ベクトルを格納しているテクスチャにはa成分だけ空きがある。
③の列のレンダリング画像は、実はその光の半減を取り入れている。
ひと通りフローチャート説明がこれで終了
カスタムシェーダは自分でくんでもらうとして 、とりあえずHSPでeasy3Dを介したHLSLによるリアルタイムレイトレーシングはこんな感じで動いている。
カスタムシェーダのソースとHSPのソースは
http://loda.jp/babadom/?id=114
からダウンロードできる。
だがこのソースははっきり言ってまだまだ改良の余地がありまくる。
今回の方法では、全てのドットで同じ処理をしないといけない制約があるので
例えば1ループ目ですでに球との交点がないドットでも、3ループ目まで当たり判定の処理をし続けないといけない。
だから全体的に無駄な処理が多い。
逆にまだまだ高速化が期待できるというわけだ。
どこまで挑戦できるか分からないが、飽くなき高速化への道はまだまだ続きそうだ。
ところでもしグラフィックボードが32bit浮動小数点の計算に対応していないとどうなるのか・・・
一応起動して、16bit浮動小数点のテクスチャで計算されるらしい。
だが少し計算にズレが生じるらしく、完成画像が少し荒くなる↓

あと前半の方でeasy3Dのバージョンが 5.2.3.3 を使用しないといけないと書いてあるが、
始めに「hspでgpgpu」を知り合いのパソコンで起動してもらおうとしたらなぜか起動しなく、その時easy3D.dllの最新バージョンを使っていた。
逆にインストール不要形式のバージョン 5.2.3.3で試してみたら動いたので、こちらを推奨しているというわけ
ちなみにその人のパソコンはwindows7でかなり最新のノートパソコンなのでDirectxは10以上だった気がするから、起動しなかった原因はよくわからない・・おちゃっこさん究明お願いします。
次回:流体力学のプログラムを作りたい!その2
PS
なんかコンテストTVに「hspでgpgpu」が紹介されてました!!審査員の方々ありがとうございます!!
あと2日で最終選考の結果が発表ですね。楽しみです